优秀产品人必懂的数据驱动增长模型 数据处理
在数据驱动增长的时代,产品人不仅要懂业务,更要懂数据。而数据驱动增长的核心,在于构建一个高效、可靠的数据处理流程。本文将深入探讨数据驱动增长模型中的数据处理环节,帮助产品人建立系统化的数据思维。
一、数据处理在增长模型中的位置
一个完整的数据驱动增长模型通常包含四个环节:数据采集、数据处理、数据分析、数据应用。数据处理承上启下:它将原始采集的杂乱数据转化为干净、规范、可分析的数据资产,为后续的洞察和决策奠定基础。如果数据处理环节薄弱,再好的分析模型也无法产出可信的结论。
二、数据处理的核心步骤
1. 数据清洗
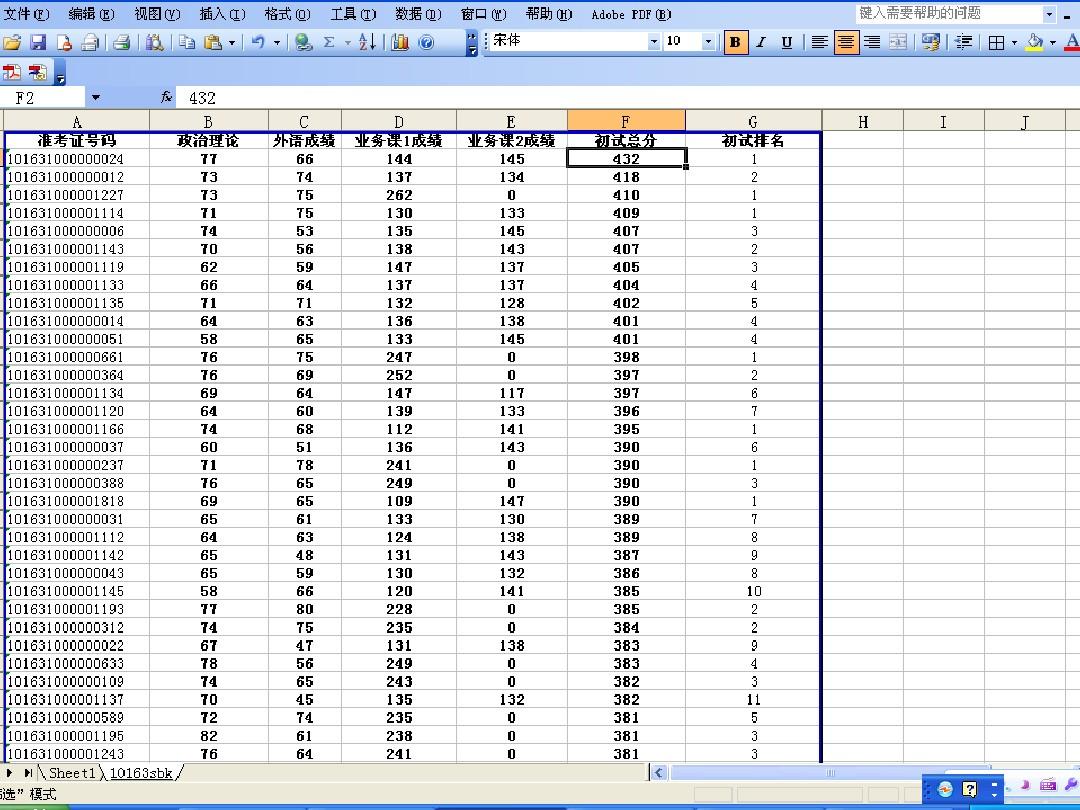
原始数据往往存在缺失值、异常值、重复记录和格式不一致等问题。数据清洗的目标是提升数据质量,确保后续分析的准确性。产品人需要与数据团队协作,定义清洗规则,例如:
- 缺失值处理:填充、插值或删除
- 异常值检测:基于业务规则或统计方法识别并处理
- 去重与标准化:统一单位、格式和编码
2. 数据转换
数据转换将清洗后的数据转化为适合分析的形态。常见操作包括:
- 聚合:按用户、时间、渠道等维度汇总指标
- 衍生:计算比率、差分、累计值等新字段
- 编码:将类别变量转换为数值型(如独热编码)
- 归一化/标准化:消除量纲影响,便于模型使用
3. 数据集成
增长分析通常需要融合多源数据,例如行为数据、交易数据、用户属性数据。数据集成要解决实体识别(如统一用户ID)和字段映射问题,构建统一的用户视图。产品人应参与设计数据埋点规范和用户标识体系,从源头降低集成难度。
4. 数据存储与管理
处理后的数据需要以合理的结构存储,常见形式包括数据仓库、数据集市和特征库。良好的数据管理应具备:
- 分层架构(ODS→DWD→DWS→ADS)
- 元数据管理,便于追溯和理解
- 数据权限与安全控制
三、数据处理的关键原则
1. 以业务为导向
数据处理不是纯技术工作。产品人应明确每个数据字段的业务含义和用途,避免过度加工或加工不足。例如,定义“活跃用户”时,需结合产品特性确定行为阈值。
2. 保证可追溯性
每一个处理步骤都应记录日志和规则版本,确保数据可回溯。当指标异常时,能快速定位是采集问题还是处理逻辑问题。
3. 自动化与实时化
增长实验往往需要快速迭代。通过ETL/ELT流水线实现自动化处理,并尽可能支持实时或准实时处理,缩短从数据产生到洞察的延迟。
4. 质量监控
建立数据质量监控体系,对关键字段设置完整性、唯一性、及时性等校验规则,异常时自动告警,防止脏数据流入分析环节。
四、产品人如何参与数据处理
产品人不需要亲自写代码,但必须深度参与:
- 定义指标口径:与数据团队共同明确核心指标的计算逻辑,写入指标字典。
- 设计埋点方案:规划关键行为的事件、属性和上报时机,确保数据采集完整。
- 参与数据验收:在新功能上线后,抽样验证数据准确性,确保处理逻辑符合预期。
- 推动数据产品化:将常用处理逻辑沉淀为数据服务或自助分析工具,提升团队效率。
五、
数据处理是数据驱动增长模型中不可或缺的一环。优秀的产品人应当理解数据处理的原理和流程,能够用业务语言与数据团队高效协作,从源头保障数据质量,为增长决策提供可靠依据。只有打好数据处理的地基,数据驱动增长才能行稳致远。