实时数据处理计算 赋能一线业务动态跟踪与关键指标监控
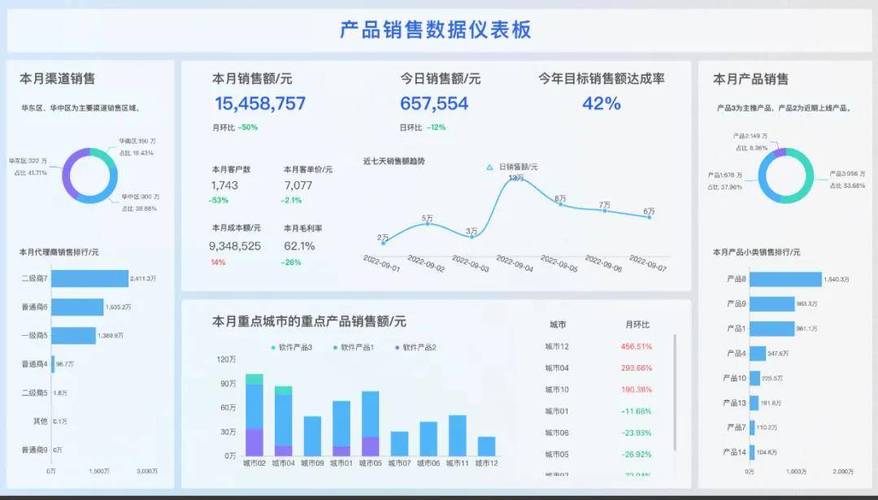
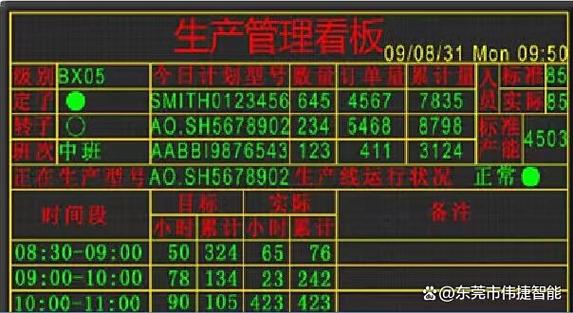
\n## 引言\n在数字化时代,市场变化瞬息万变,一线业务人员需要及时掌握业务动态和关键指标,才能快速响应、精准决策。传统的批处理模式存在小时级甚至天级的延迟,无法满足实时性要求。实时数据处理计算技术应运而生,它通过流式数据处理架构,实现对业务数据的实时采集、计算和分析,让一线业务人员能够像驾驶舱一样实时观测业务状态,从而提升运营效率和市场竞争力。\n\n## 一、实时数据处理的核心价值\n实时数据处理计算的核心在于“实时”二字,其价值主要体现在三个方面:\n\n1. 业务动态跟踪:通过实时采集订单、交易、用户行为等数据流,计算当前业务量、成功率、地域分布等,让一线人员实时感知业务脉动,及时调整策略。\n2. 重要指标监控:对关键性能指标(KPI)如销售额、转化率、客单价、库存周转等进行实时计算和预警,确保业务目标可控。\n3. 快速决策支持:基于实时数据结果,业务人员可以立即发现问题并采取措施,例如流量异常时触发营销活动、库存不足时自动补货建议等。\n\n## 二、实时数据处理架构设计\n实现高效的实时数据处理需要一套完整的流式处理架构,通常包括以下组件:\n\n### 1. 数据采集层\n负责从业务系统、日志文件、传感器等数据源实时采集数据。常用工具有Flume、Logstash、Filebeat,或直接使用消息队列如Kafka、Pulsar作为数据管道,实现高吞吐、低延迟的数据接入。\n\n### 2. 实时计算层\n核心组件是流处理引擎,如Apache Flink、Spark Streaming、Kafka Streams等。Flink凭借其低延迟、Exactly-Once语义和状态管理能力,成为主流选择。计算层负责对数据流进行转换、聚合、窗口计算等操作,并输出结果。\n\n### 3. 存储与查询层\n实时计算结果通常需要存储到快速查询的数据库中,如时序数据库(InfluxDB、TimescaleDB)、NoSQL数据库(HBase、Redis)或OLAP引擎(ClickHouse、Doris)。这些存储系统支持高并发写入和低延迟查询,方便前端展示和监控。\n\n### 4. 应用展示层\n通过BI工具(如Tableau、番薯-Penguin、EDW)、实时大屏或API接口,将计算结果呈现给一线业务人员。动效展现实时数据更新和灵活筛选提升了交互体验。\n\n典型流程图:数据源 -> 数据采集 -> 消息队列 -> 流计算引擎 -> 存储 -> 应用展示 -> 业务人员。\n\n## 三、关键实现技术步骤\n\n### 步骤1:需求分析与指标定义\n明确一线业务关心哪些动态和指标,例如每日销售额、站点转化或用户队列漏斗。建议先从关键L1指标入手,例如业务核心状态与KPI告警及快速下钻的设计。\n\n### 步骤2:数据模型设计,将有效及时通过CDC(变更抓取)方案、消息队列模板结构订阅;ODS原始质量基于分析加工进入规范清晰,字段对齐。\n\n再接着我可以为你提出或者动手真实配置建模,但主要难点可关注下游复用聚合表的消息包括主题订阅以及文档。我们来共同详细设计分区粒度\