工程数据处理 从原始数据到工程洞察

在工程领域,数据是决策的基石。无论是土木监测、机械测试、电气测量还是化工过程控制,我们每天都会产生海量的原始数据。原始数据本身往往杂乱、重复、含有噪声,甚至存在缺失或异常。只有经过科学的处理,才能转化为可靠的工程信息,为设计优化、安全评估和故障诊断提供支撑。因此,“工程数据处理”绝非简单的计算,而是一套贯穿数据全生命周期的严谨方法论。
一、工程数据处理的典型流程
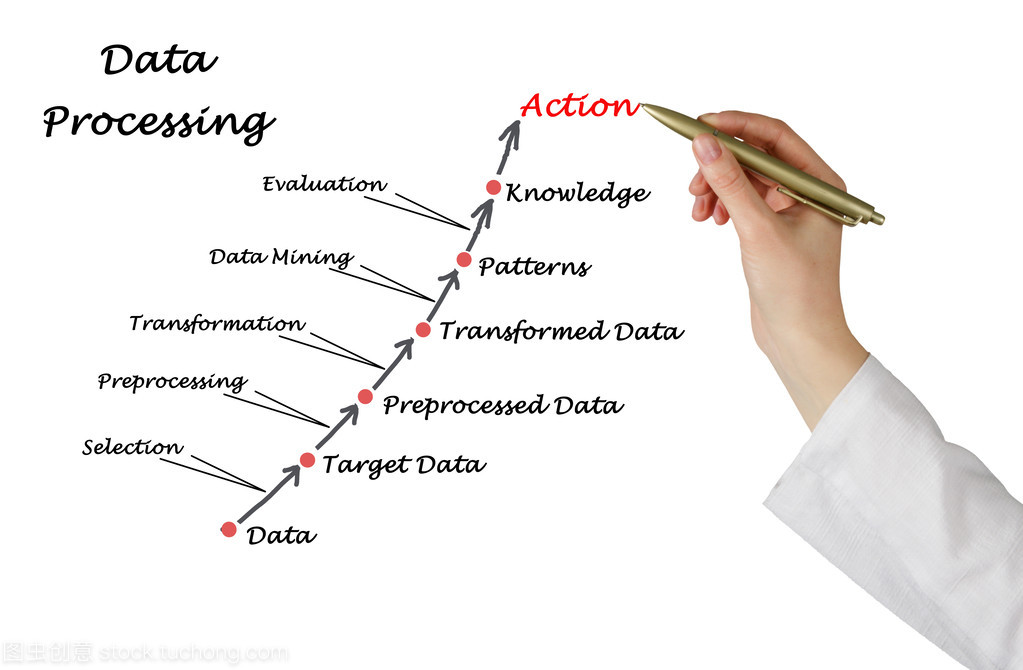
完整的工程数据处理通常遵循以下六个核心步骤:
1. 数据采集与清洗
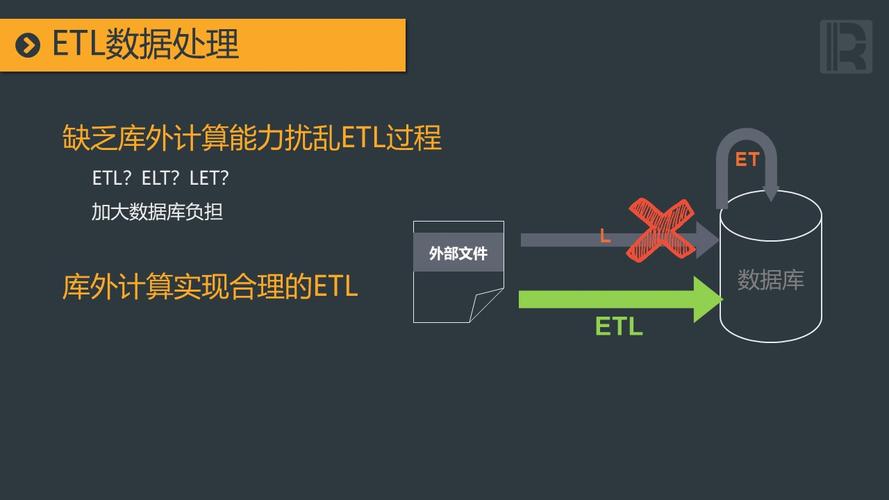
从传感器、仪器、日志或数据库中获取原始数据后,首先需要剔除无效记录、填补缺失值、处理重复条目。清洗的目标是保证数据的完整性和一致性,避免“垃圾进、垃圾出”。
2. 数据变换与归一化
不同物理量往往具有不同的量纲和数量级(如压力单位为MPa,位移单位为mm)。通过标准化(Z-score)或归一化(Min-Max)将数据映射到统一尺度,能显著提升后续算法(如神经网络、聚类)的稳定性和收敛速度。
3. 特征提取与选择
原始时间序列或图像数据维度极高,直接分析效率低下。工程师常用时域统计(均值、方差、峰值)、频域变换(FFT、小波)或时频分析提取关键特征,再通过相关性分析、主成分分析等筛选出对目标任务最有贡献的特征,降低模型复杂度。
4. 数据融合与对齐
多源数据(如温度、振动、电流)在时间戳和采样率上常不一致。通过时间对齐、插值或卡尔曼滤波进行融合,才能还原工程系统的完整状态。
5. 异常检测与稳健处理
工程数据中异常值可能来自传感器故障或真实事件。使用3σ准则、箱线图或孤立森林识别异常点,并根据业务背景选择剔除、修正或保留。稳健的统计方法(如中位数、鲁棒回归)能减少异常值对整体结论的干扰。
二、核心方法与工具
- 统计方法:假设检验、回归分析、方差分析,用于探索变量关系和显著性。
- 信号处理:滤波(低通、高通、带通)、频谱分析、相关分析,适用于振动、声学、电磁信号。
- 机器学习:聚类、分类、回归、降维,常用于模式识别与预测性维护。
- 专业软件:MATLAB、Python(Pandas、NumPy、SciPy、Scikit-learn)、R、LabVIEW及各类工程仿真平台。
三、典型应用场景
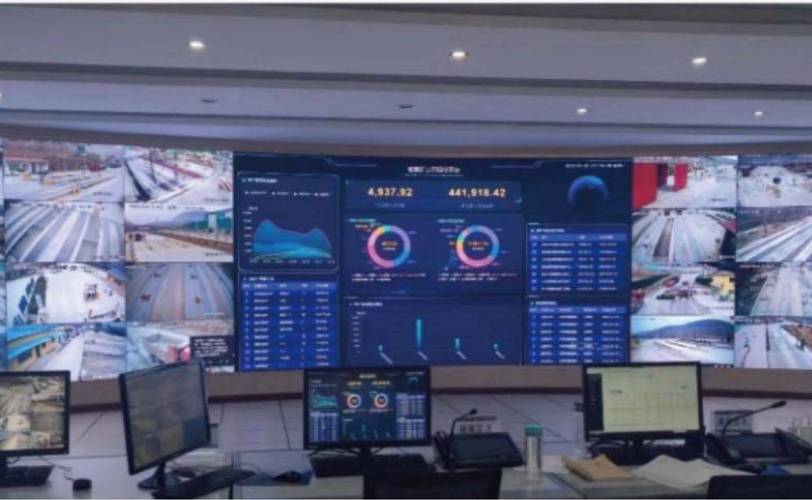
- 结构健康监测:处理应变、加速度数据,识别桥梁或建筑的损伤位置。
- 旋转机械故障诊断:分析振动信号,提取故障特征频率,预警轴承或齿轮失效。
- 智能制造:对生产线传感器数据实时清洗与融合,实现质量在线预测。
- 环境工程:处理气象、水质时间序列,评估污染趋势与治理效果。
四、实践中的关键原则
1. 理解物理背景
数据处理不能脱离工程对象。只有明白数据的物理含义,才能正确选择处理策略,避免“为算法而算法”。
2. 保留可追溯性
每一步处理都应记录参数与方法,确保结果可复现、可审计,这对于安全关键系统尤为重要。
3. 权衡精度与效率
复杂算法可能带来更高精度,但实时控制场景下需优先考虑计算延迟。工程师应根据需求选择适当的方法。
4. 可视化验证
在处理前后绘制数据分布、趋势图和残差图,是发现隐含问题和验证处理效果的速度最快、成本最低的手段。
五、
工程数据处理是将原始信号转化为工程智慧的桥梁。它既需要扎实的数学与编程功底,也离不开对工程问题的深刻理解。随着物联网和工业大数据的普及,数据的体量与复杂度持续攀升,唯有建立规范化、可复用的数据处理流程,才能让数据真正驱动工程创新与安全运行。