小红书推荐业务的实时计算与数据驱动突破 数据处理
在社交媒体与内容社区高速发展的今天,小红书作为以UGC(用户生成内容)为核心的平台,其推荐系统面临着海量数据实时处理与精准分发的双重挑战。实时计算与数据驱动已成为推荐业务突破性能瓶颈、提升用户体验的关键抓手。本文将聚焦小红书推荐业务中的数据处理环节,探讨实时计算架构的演进、数据驱动策略的落地以及两者融合带来的业务价值。
一、推荐业务数据处理的特殊性
小红书的推荐场景兼具“社区”与“电商”双重属性:用户既消费图文/视频笔记,也产生购买行为。这要求数据处理链路同时满足低延迟(秒级响应互动信号)、高吞吐(日均百亿级行为事件)和强一致性(特征与样本对齐)。传统离线批处理模式无法捕捉用户实时兴趣漂移,因此必须构建“流批一体”的数据处理体系。
二、实时计算架构的核心设计
1. 数据采集与传输层
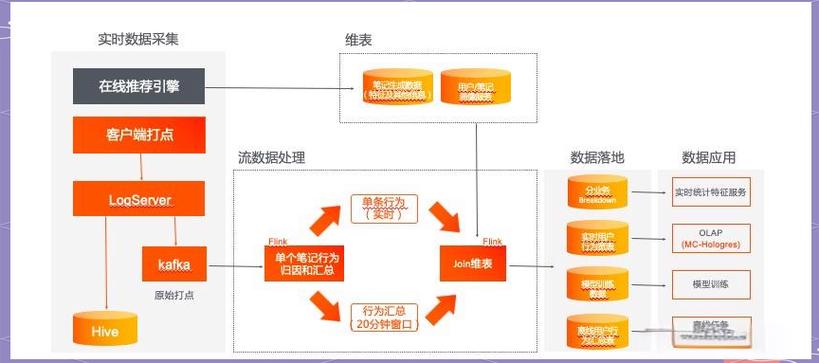
客户端埋点通过SDK采集曝光、点击、停留、滑动等行为,经消息队列(如Kafka)缓冲后进入实时计算引擎。为保障端到端延迟<3秒,采用分层Topic设计:原始日志Topic按业务线隔离,清洗后的标准化事件Topic供下游消费;同时引入Schema Registry保证数据结构兼容性。
2. 流式处理引擎选型与优化
采用Flink作为实时计算核心,关键优化包括:
- 状态管理:利用RocksDB状态后端存储用户会话窗口内的行为序列,窗口大小动态调整(活跃用户5分钟,沉默用户30分钟);
- 反压感知:通过Flink Metrics监控各算子吞吐,自动扩缩容TaskManager;
- 维表关联:异步IO关联用户画像与内容元数据,设置LRU缓存降低外部存储压力。
3. 实时特征工程流水线
将特征分为三类:
- 统计类(如近1小时点击率):窗口聚合后写入HBase供在线查询;
- 序列类(如最近10次交互序列):通过Flink CEP提取模式,Embedding化后存入Redis;
- 交叉类(用户-内容匹配度):轻量级模型在线推理,特征实时拼接。
所有特征统一注册到Feature Store,保证训练与推理一致性。
三、数据驱动的推荐策略突破
1. 冷启动场景的实时探索
针对新笔记/新用户,利用实时计算构建“探索池”:对笔记按内容标签分组,结合Thompson Sampling算法在流式数据中动态调整曝光概率。实践表明,冷启动笔记的点击率提升22%,7日留存提高15%。
2. 多目标实时融合排序
将实时行为信号(如即时完播率、快速滑走)作为负反馈特征输入排序模型,通过在线学习(FTRL)实时更新权重。为保证稳定性,采用双塔结构:实时塔输出调整系数,离线塔输出基础分,最终得分相乘。A/B测试显示,多目标实时融合使人均使用时长增加8.6%。
3. 异常流量实时过滤
基于Flink规则引擎识别刷量行为(如短时高频同质交互),实时计算设备指纹相似度、行为时间熵等指标,异常内容进入人工审核队列。上线后作弊曝光占比下降至0.3%。
四、挑战与未来方向
当前面临主要挑战包括:
- 延迟与精度的权衡:实时特征窗口过短导致噪声大,需探索自适应窗口算法;
- 存储成本:特征Store与状态后端资源消耗高,可考虑压缩编码与TTL分级;
- 流批一体落地:离线样本与实时特征的对齐误差仍需优化。
小红书推荐数据处理将向“实时智能”演进:引入轻量级在线学习框架实现分钟级模型更新;探索湖仓一体架构统一流批数据源;利用图计算实时挖掘用户-内容-作者的社群关系。通过持续的数据驱动突破,让每一条优质内容都能被即时、精准地触达兴趣用户。